Prompt Software · Sprachausgabe
Lectern: Text-to-Speech mit Stimmklon für den Mac
Text in natürliche Sprache verwandeln, mit fertigen Stimmen oder deiner eigenen.
Schreib oder importiere ein Dokument, gib jedem Absatz eine Stimme und eine Stimmung und hör zu. Klone deine eigene Stimme aus 15 Sekunden Vorlesen oder beschreibe eine neue. Speichere MP3, WAV oder ein Hörbuch mit Kapiteln. Das Sprachmodell läuft auf der Grafikeinheit deines Macs, Text und Stimme bleiben auf dem Mac.
- Sprachen
- 10
- Modellgrößen
- 1.7B und 0.6B
- Importformate
- 16
- Oberflächensprachen
- 9

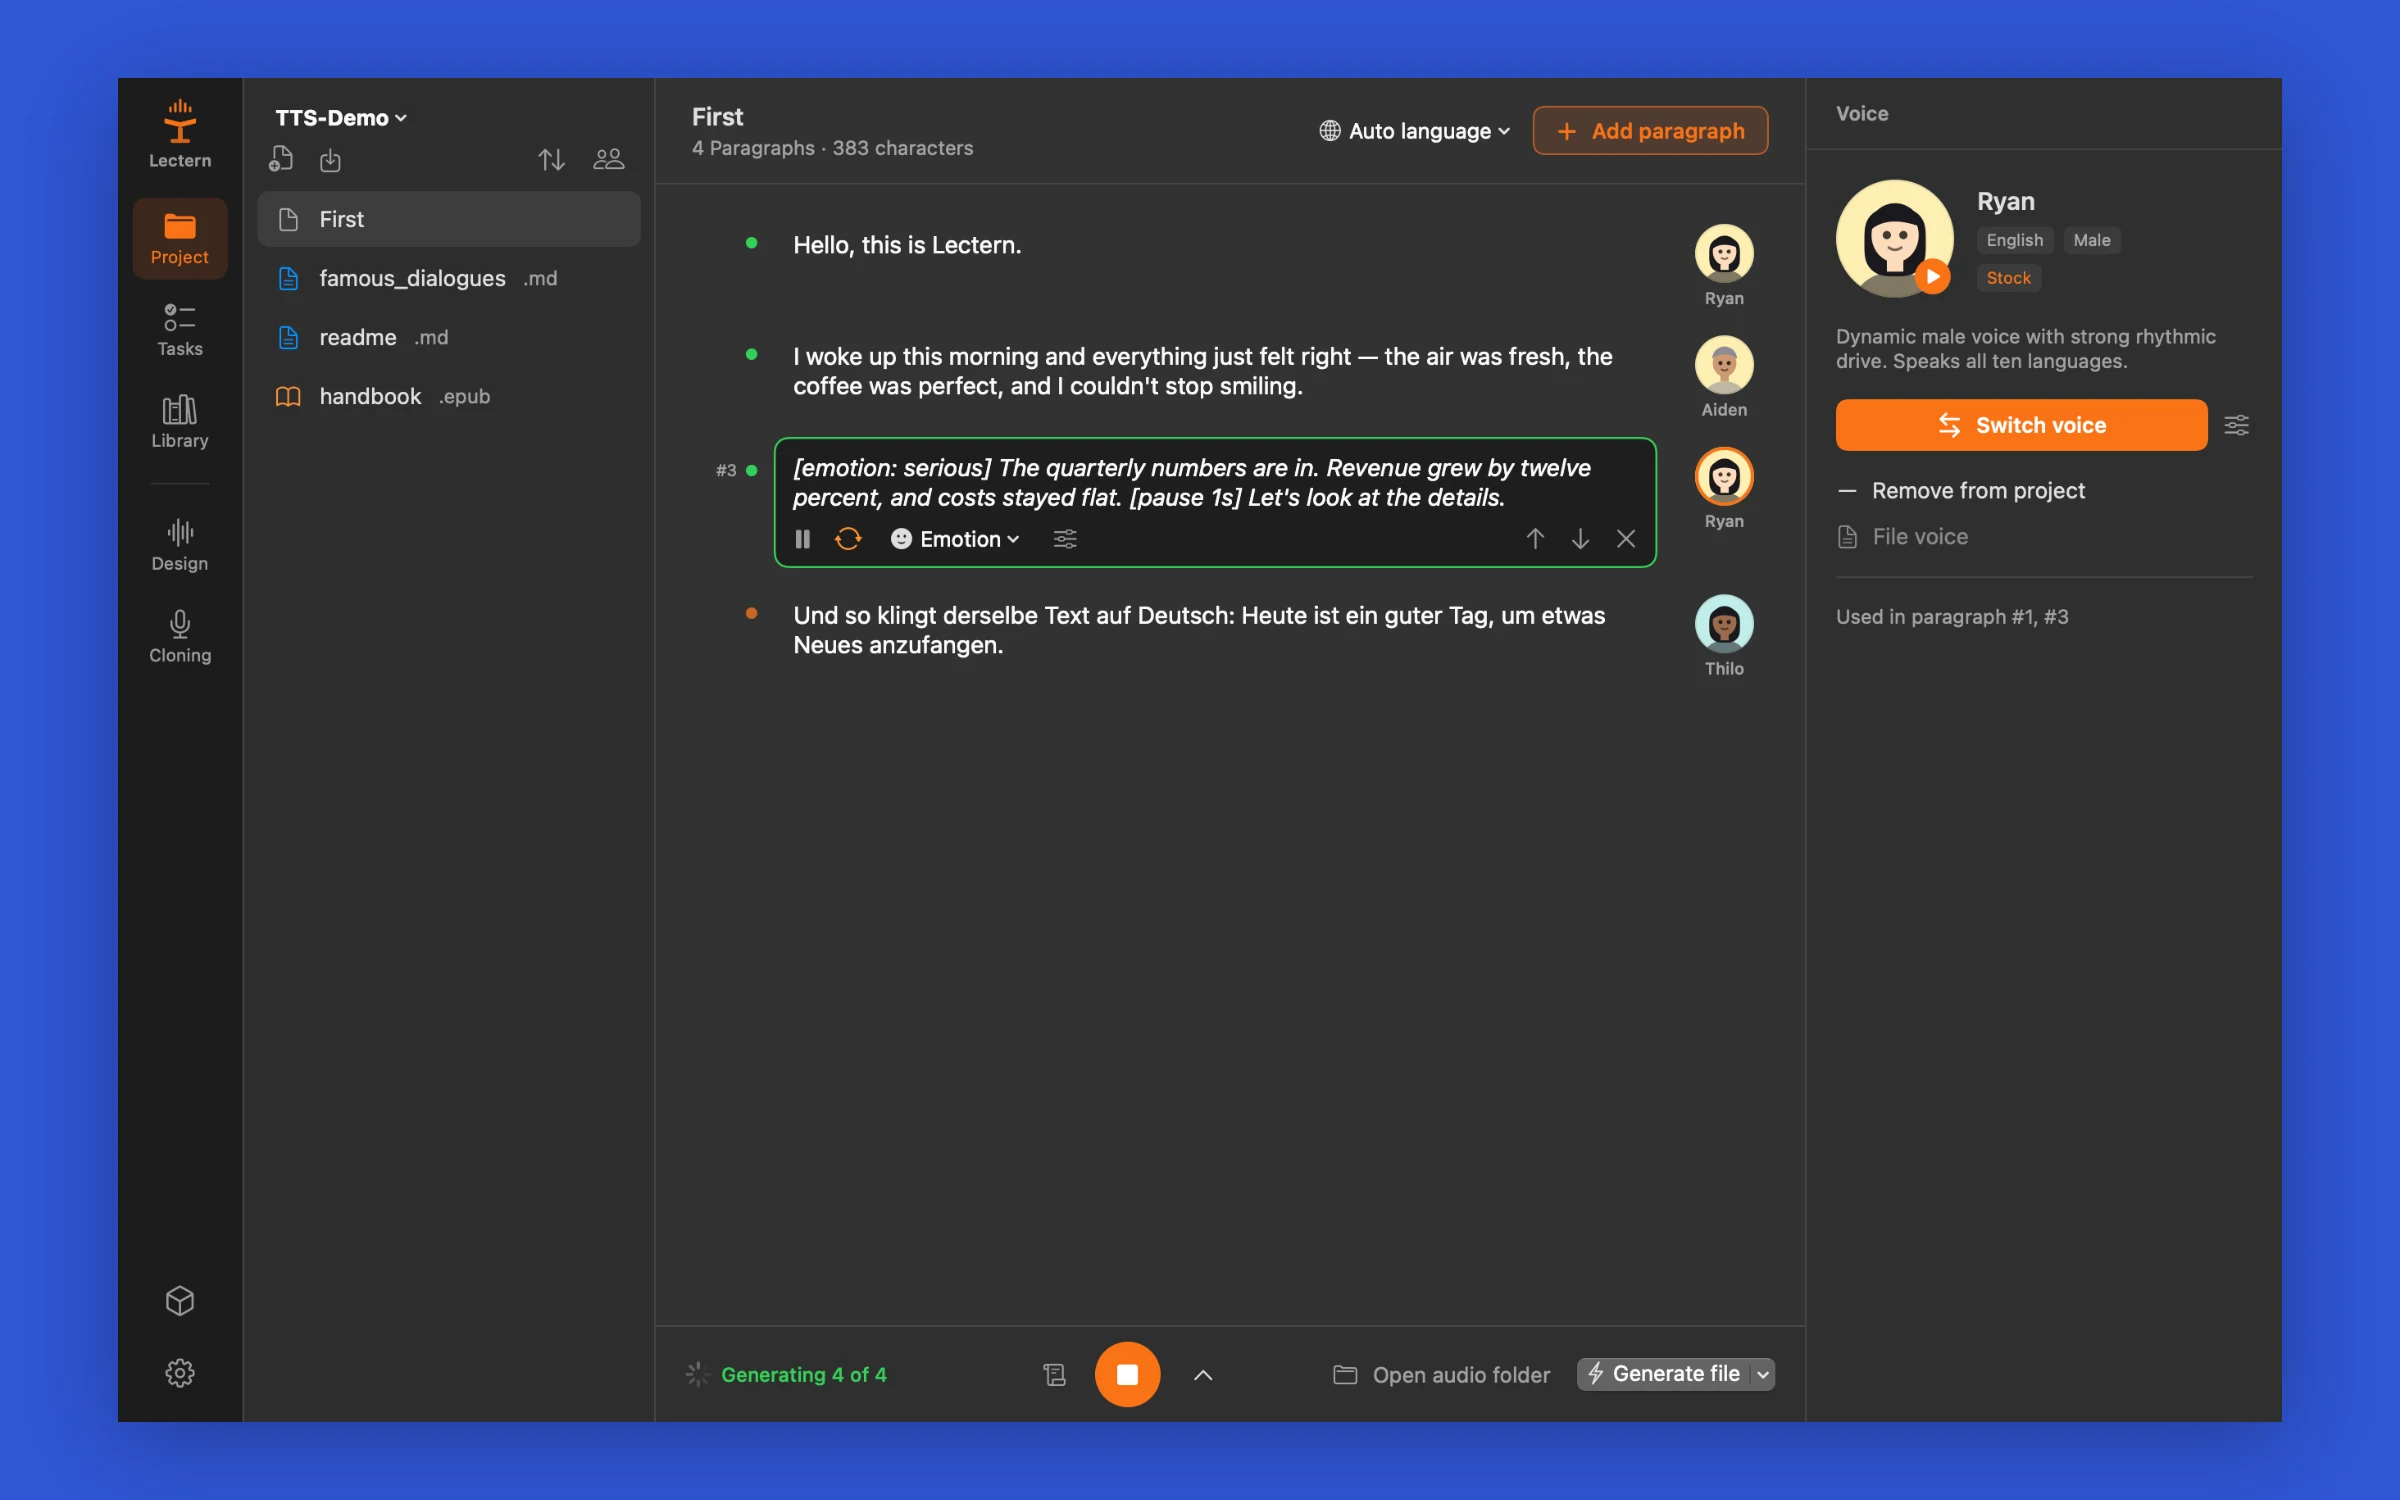
Was es kann
Deine eigene Stimme aus einer Lesung
Lies einen kurzen Text vor, der mit einem sechsstelligen Code endet. Lectern prüft auf dem Mac, dass du ihn gelesen hast, entfernt Hintergrundrauschen wie einen Computerlüfter, klont die Stimme und zeigt, wie ähnlich sie ist. Eine deutsche Aufnahme reicht, damit die Stimme auch Englisch spricht.
Eine Stimme und eine Stimmung pro Absatz
Aufgeregt, fröhlich, verwirrt, wütend, ernst, gelangweilt, traurig, verlegen, ruhig oder geflüstert, oder eine eigene Anweisung wie "langsam, als würdest du ein Geheimnis erzählen". Tempo, Tonhöhe, Lautstärke und Pausen pro Stimme oder pro Absatz.
Drehbücher mit Besetzung
Zeilen, die mit einem Namen und einem Doppelpunkt beginnen, werden zu Figuren. Gib jeder Figur einmal eine Stimme, und der ganze Dialog wird in diesen Stimmen gelesen.
Neue Stimmen aus einer Beschreibung
Beschreibe Alter, Klang und Stil, hör dir drei Vorschläge an und behalte einen. Eine behaltene Stimme klingt in jedem Absatz gleich. Oder verfeinere eine Basisstimme mit einer Anweisung wie "älter und langsamer" und behalte sie.
Dokumente rein, Hörbücher raus
Importiert TXT, Markdown, PDF, Word, RTF, OpenDocument, EPUB, PowerPoint, Excel, HTML, die Untertitelformate SRT, VTT, LRC und ASS und Fountain-Drehbücher, oder öffnet einen ganzen Ordner als Projekt. Exportiert MP3, WAV, M4A, FLAC, AIFF oder ein M4B-Hörbuch mit einem Kapitel pro Kapitel oder pro Absatz, dazu SRT-Untertitel. Jede Datei ist als KI-Sprache gekennzeichnet, in den Metadaten und mit einem unhörbaren Wasserzeichen.
Zuhören, während es entsteht
Spiel einen Absatz, ein Kapitel oder alles ab. Die Wiedergabe beginnt, bevor der Rest erzeugt ist, und Stapelaufgaben machen aus vielen Dokumenten in einem Durchgang Audiodateien.
Screenshots
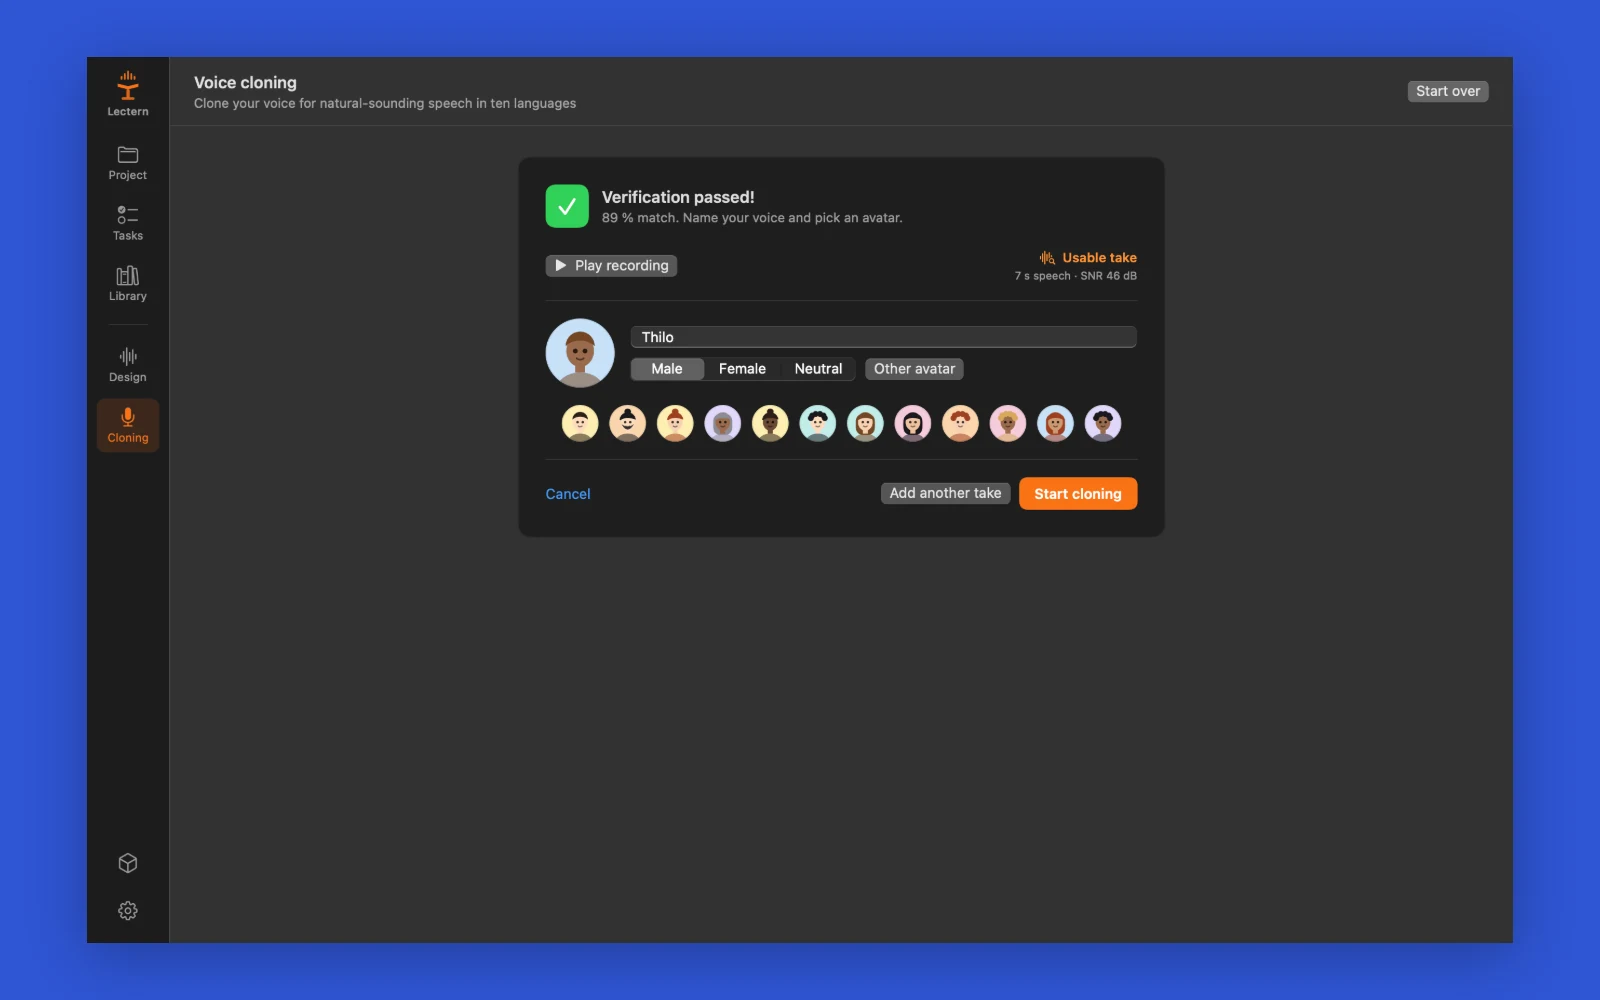
Die eigene Stimme klonen: Lies einen kurzen Text mit sechsstelligem Code vor, Lectern prüft die Lesung auf dem Mac und bewertet die Aufnahme. Bis zu drei Aufnahmen, dann wird geklont. 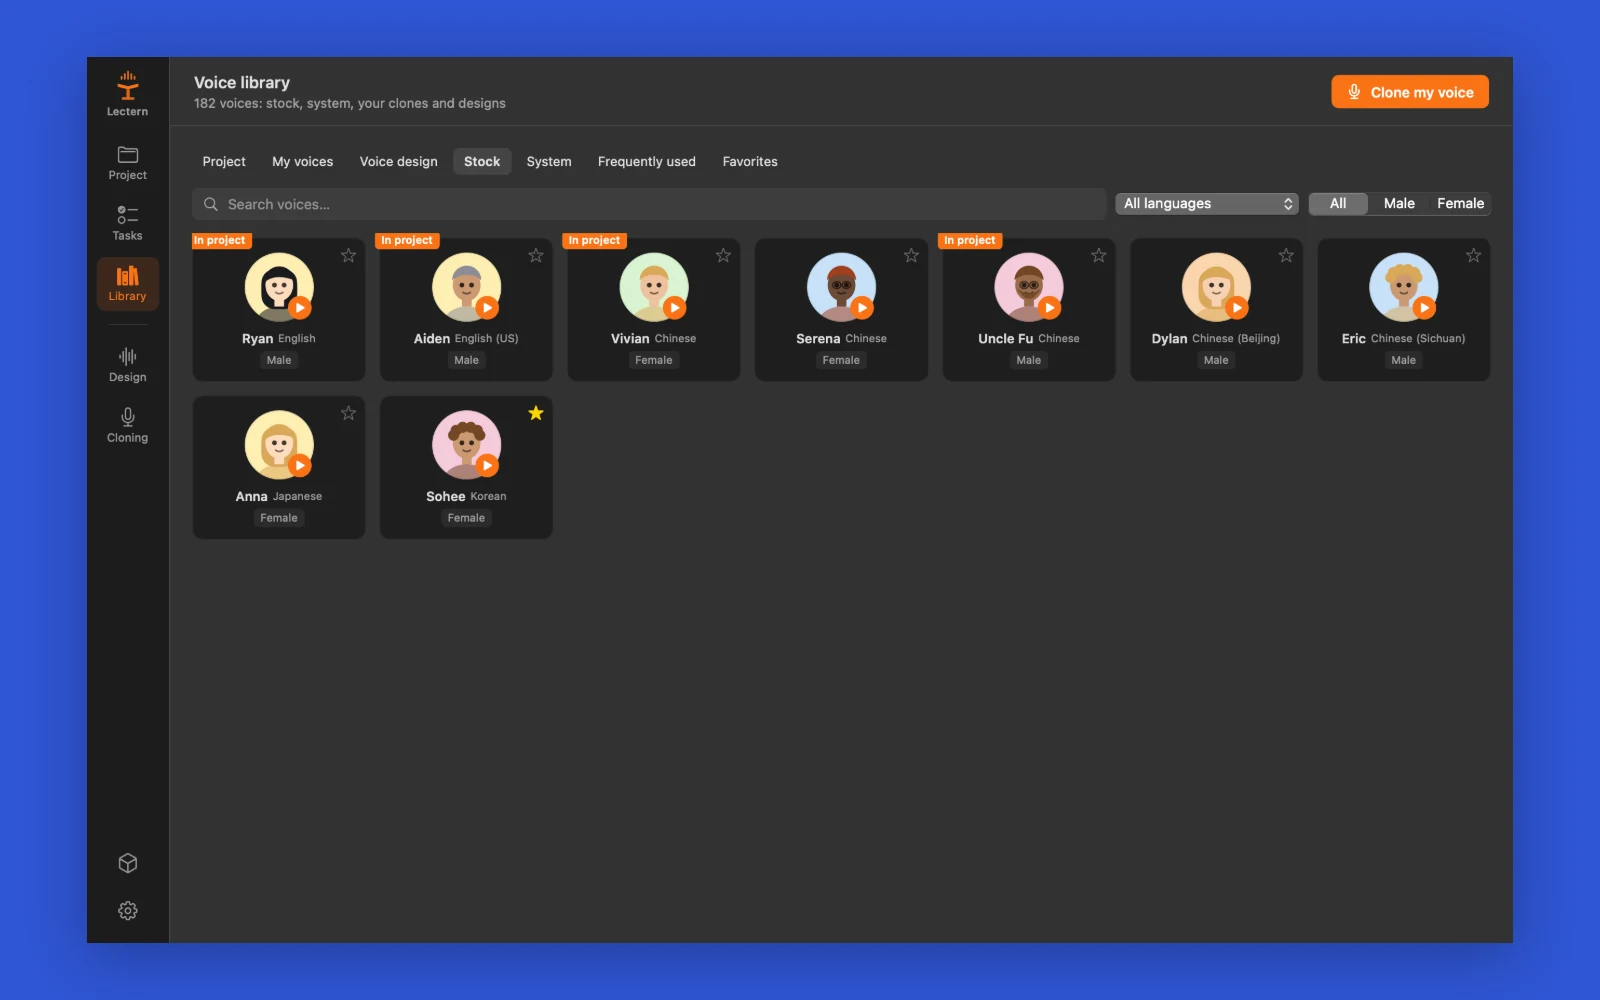
Eine Stimme wählen: neun fertige Stimmen in zehn Sprachen, die macOS-Stimmen und deine eigenen Klone und Entwürfe, mit Suche, Sprach- und Geschlechtsfilter. 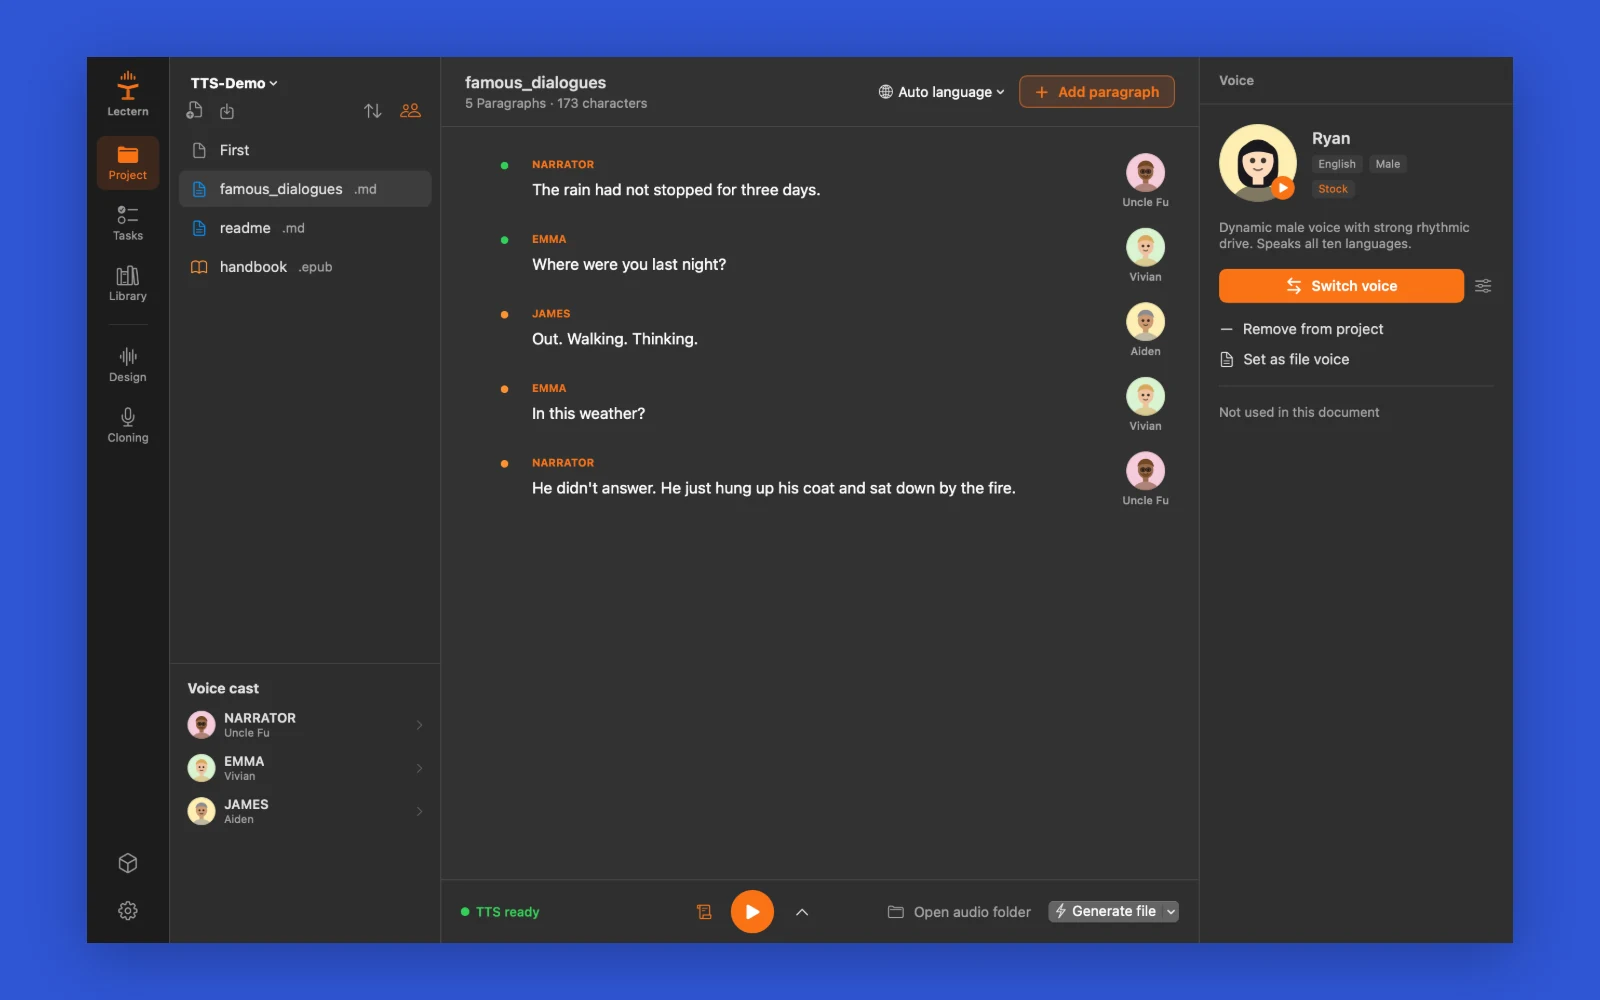
Ein Drehbuch besetzen: Zeilen, die mit einem Namen und Doppelpunkt beginnen, werden Figuren. Wähle einmal eine Stimme pro Figur, dann wird der Dialog in diesen Stimmen gelesen. 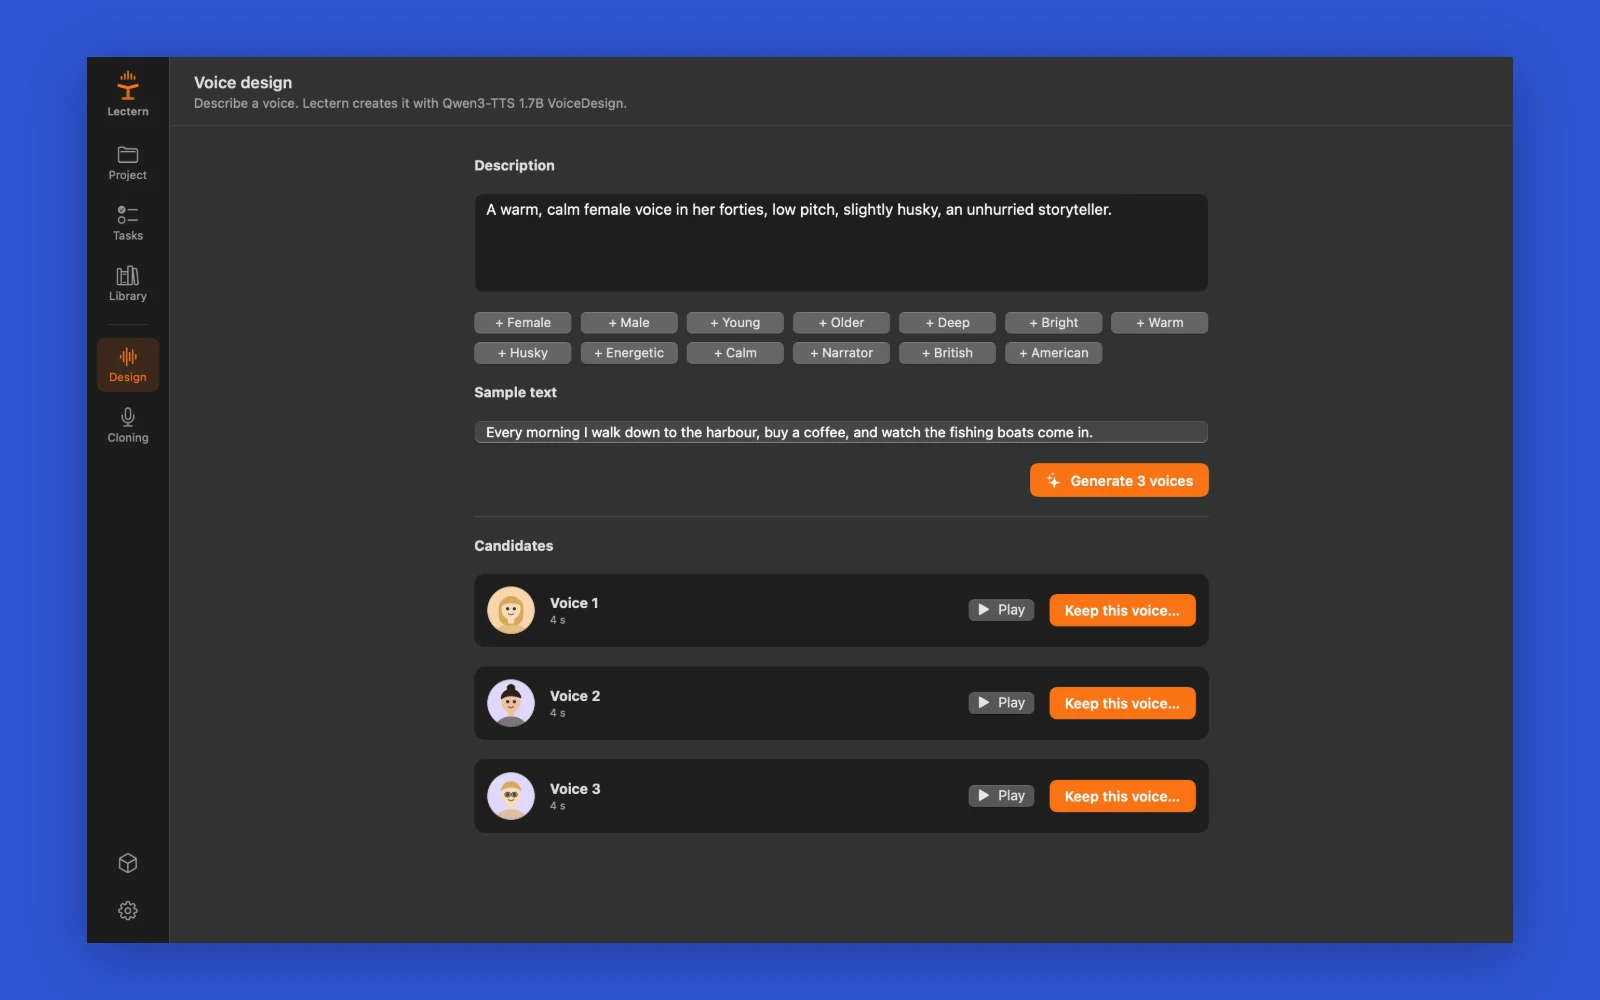
Eine Stimme aus Worten entwerfen: Beschreibe Alter, Klang und Stil, hör dir drei Vorschläge an und behalte einen. Eine behaltene Stimme klingt in jedem Absatz gleich.
Systemvoraussetzungen
- macOS 15 oder neuer
- Mac mit Apple Silicon
- 3 bis 9 GB Speicherplatz für die Sprachmodelle, Download in der App
- 16 GB Arbeitsspeicher empfohlen für die 1.7B-Modelle
Netzwerkzugriffe
Außer zur Lizenzprüfung verbindet es sich nur mit diesen Diensten, und nur für die genannte Funktion:
- Hugging Face, um die Sprachmodelle zu laden, wenn du sie anforderst
Mehr aus dieser Produktlinie
Passwörter und API-Keys
Hidewell
Passwörter und API-Keys in einer verschlüsselten Datei auf deinem Mac.
macOS 13+19 €
Ordner vergleichen und abgleichen
Mirrorline
Zwei Ordner nebeneinander vergleichen und so abgleichen, wie du willst.
macOS 14+19 €
Speicheranalyse
Spacewalk
Sieh, was deine Festplatte füllt, und räume große Dateien Karte für Karte ab
macOS 14+Kostenlos